
AI는 준비됐는데, 우리 데이터는요?
AI는 준비됐는데, 우리 데이터는요?
AI 자동화를 검토 중인 대표님과 실무자분들께 드리는 이야기입니다.
이번 호에서는 AI 도입이 데모에서 멈추는 진짜 이유, 그리고 자동화 전에 먼저 챙겨야 할 것을 다룹니다.

혹시 이런 경험, 한 번쯤 있으시지 않나요?
AI 도입 미팅. 데모는 순조로웠습니다.
샘플 데이터를 넣자 보고서가 몇 초 만에 나왔고, 회의실 분위기도 좋았죠.
그런데 "이제 우리 데이터로 해볼까요?" 한마디에 공기가 달라집니다.
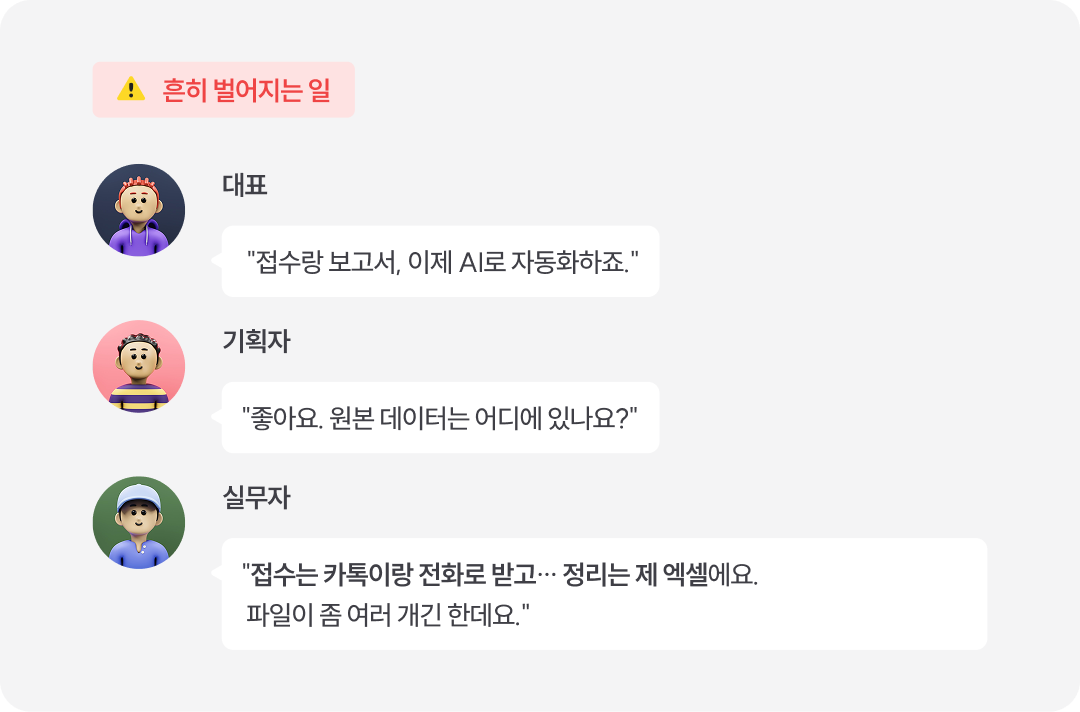
문제는 AI가 똑똑하지 않아서가 아니라, AI에게 건넬 재료가 준비되지 않았다는 것입니다.
요리 로봇은 장을 봐주지 않습니다
최고급 요리 로봇을 들여도 냉장고가 비어 있으면 요리는 나오지 않습니다.
재료가 여기저기 흩어져 있고 이름표도 없다면, 로봇은 멈추는 대신 그럴듯한 대체 재료를 골라 요리를 완성해 버립니다.
AI도 똑같습니다. 데이터가 흩어져 있거나 형식이 제각각이면, AI는 빈칸을 추측으로 채웁니다.
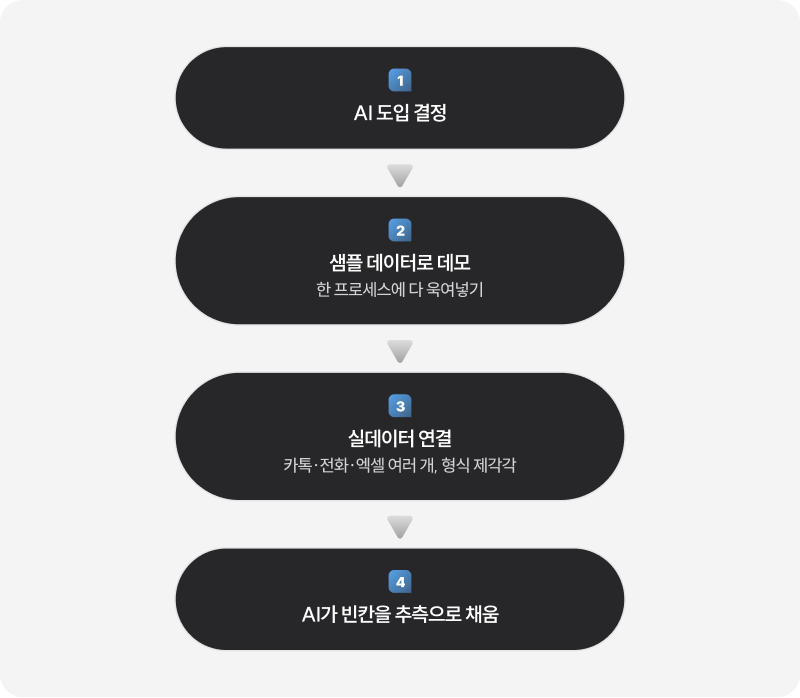
결과물은 늘 그럴듯해 보입니다. 그래서 더 곤란합니다.
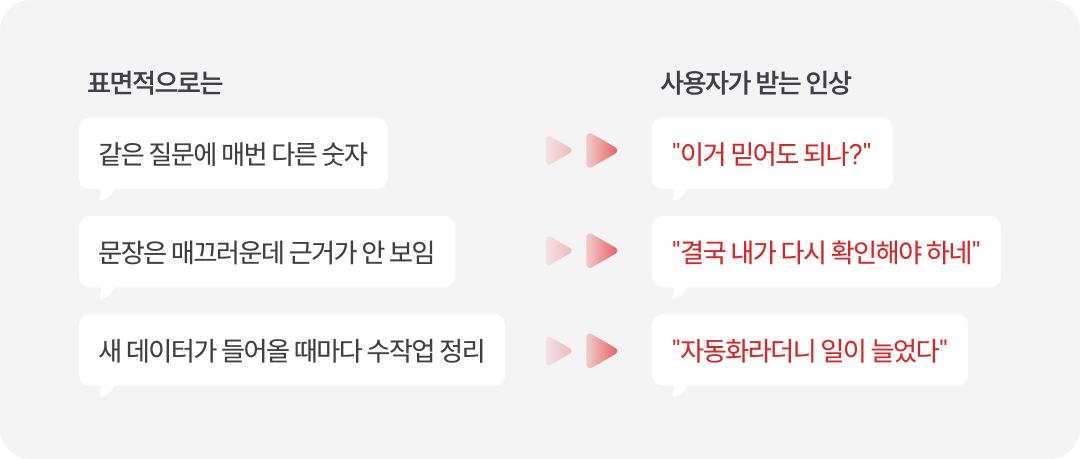
결국 필요한 건 '더 똑똑한 AI'가 아니라 '먼저 쌓이는 구조'입니다
자동화가 잘 되는 회사와 안 되는 회사의 차이는 AI 모델이 아니라 그 앞단에 있습니다.
데이터가 어디서 들어와, 어디에, 어떤 모양으로 쌓이는지가 정해져 있으면 AI는 그 위에서 추측 대신 조회를 합니다.
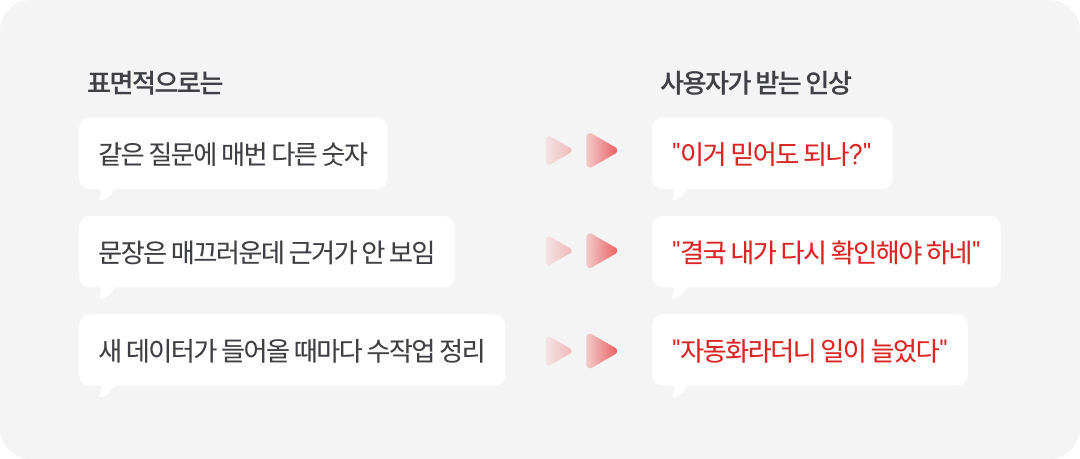
네 가지가 갖춰지면 자동화는 거창한 '도입'이 아니라 자연스러운 다음 단계가 됩니다.
우리도 같은 고민을 먼저 겪었습니다
레피소드도 처음엔 "어떤 AI를 붙일까"부터 고민했습니다.
하지만 회의록·채팅·음성 메모에서 요구사항을 뽑아내는 사내 도구를 만들 때도,
출발점은 모델이 아니라 흩어진 원문을 어떤 구조로 쌓을지였습니다.
"좋은 AI 파트너는 모델을 먼저 고르지 않습니다. 데이터가 쌓일 자리를 먼저 봅니다."
이 기준을 만들어가며 실제로 우리가 한 일들입니다.
01. 형식이 달라도, 입구는 하나로
A/S 접수 시스템에서 이미지·PDF는 OCR과 멀티모달 AI로, 채팅은 대화 맥락 분석으로,
통화는 음성 인식 후 요약으로 처리했습니다.
입력 방식은 달라도 모두 '확인 → 해석 → 구조화 → 등록'이라는 같은 흐름을 거쳐 하나의 접수 데이터로 쌓입니다.
02. 모으는 구조가 먼저, 통계는 그다음
기존 DB, 엑셀·문서, 외부 API, AI가 추출한 데이터를 하나의 스키마로 정리해 적재했습니다.
그러자 추이·상태별 건수·TOP N 같은 통계가 자동으로 나오기 시작했고, 리포트 자동화와 자연어 조회로 넓혀갈 길도 열렸습니다.
03. 사실은 데이터가, 문장은 AI가
공사 현장 안전 리포트에서는 사고 사례 공공데이터 76만 건과 현행 산업안전보건법 조문을 근거로 두고,
AI에게는 추론과 요약만 맡겼습니다.오답이 곧 사고로 이어지는 영역이라, AI가 생성할 수 있는 범위부터 데이터로 좁혔습니다.
04. AI의 판단도 데이터로 남긴다
A/S 접수 초안은 AI가 먼저 쓰되, 최종 확정은 사람이 합니다.
그리고 AI의 1차 판단과 최종 결과를 대조해 정확도를 지표로 추적합니다.
"믿을 수 있냐"는 질문에 감이 아니라 숫자로 답하기 위해서입니다.
AI를 고르기 전에, 데이터가 쌓일 자리부터 봐주세요
"우리 회사도 AI 자동화가 될까?" 궁금하시다면, 어떤 AI를 쓸지보다
지금 데이터가 어디에 어떻게 쌓이고 있는지부터 함께 살펴보면 좋겠습니다.
흩어져 있다면 어떻게 모을지, 아직 쌓이지 않았다면 어떻게 쌓을지. 레피소드는 늘 거기서부터 시작합니다.


"AI는 재료를 만들어주지 않습니다. 잘 쌓인 재료 위에서 비로소 제 실력을 냅니다."
